© 1999
François Bry
Dieses Lehrmaterial wird ausschließlich zur privaten Verwendung
angeboten. Eine nichtprivate Nutzung (z.B. im Unterricht oder eine
Veröffentlichung von Kopien oder Übersetzungen) dieses Lehrmaterials
bedarf der Erlaubnis des Autors.
3.8 Herbrand-Interpretationen und Skolemisierung
Die Folgerungsbeziehung und andere semantische Begriffe sind mit
den bisherigen Definitionen zwar formal präzise
charakterisiert, aber auf eine Art, die keine Grundlage für
eine algorithmische Behandlung bietet. Betrachten wir zum Beispiel
die Frage, ob zwischen zwei
 -Formeln
F und G die Folgerungsbeziehung besteht. Nach Definition besteht sie genau
dann, wenn jede Interpretation, die F erfüllt, auch G
erfüllt. Eine Interpretation wiederum basiert auf
einer beliebigen nichtleeren Menge als Universum. Es gibt also
mindestens so viele Interpretationen wie es Mengen gibt, und
für jede davon wäre zu überprüfen, ob sie, wenn
sie F erfüllt, auch G erfüllt. Darauf
lässt sich kein Algorithmus aufbauen.
Damit liegt die Frage nahe, ob man vielleicht gewisse
,,Referenzinterpretationen`` auszeichnen kann, so dass man zum
Nachweis der Folgerungsbeziehung die genannte Überprüfung
nicht für jede überhaupt mögliche Interpretation
durchführen muss, sondern nur für diese
Referenzinterpretationen. Das wäre ein wichtiger
Zwischenschritt in Richtung Algorithmisierung.
Tatsächlich haben wir im Zusammenhang mit der Gleichheit
bereits etwas ähnliches kennengelernt. In
Satz 3.6.6 wurde die
Folgerungsbeziehung  ja auf die Beziehung
 zurückgeführt. Wenn die Gleichheitsaxiome
beteiligt sind, braucht man zum Nachweis der Folgerungsbeziehung
die Überprüfung also nicht für sämtliche
Interpretationen durchzuführen, sondern kann sich auf die
normalen Interpretationen beschränken.
Natürlich nützt die Beschränkung auf normale
Interpretationen nicht viel im Hinblick auf die
Algorithmisierbarkeit, da ja auch die normalen Interpretationen
jede beliebige nichtleere Menge als Universum benutzen können,
doch zeigt das Ergebnis immerhin, dass die Idee der
Referenzinterpretationen nicht von vornherein aussichtslos ist. Die
angestrebten Referenzinterpretationen sollten aber in erster Linie
bewirken, dass weniger Universen betrachtet werden müssen.
Genau das ist für Herbrand-Interpretationen der Fall. Alle
Herbrand-Interpretationen basieren auf einem einzigen
ausgezeichneten Universum, dem sogenannten Herbrand-Universum.
Wenn die beteiligten Formeln eine bestimmte syntaktische
Eigenschaft haben, nämlich universell sind, reicht es
tatsächlich aus, zum Nachweis der Folgerungsbeziehung die
Überprüfung nur für Herbrand-Interpretationen
durchzuführen statt für sämtliche Interpretationen.
Zudem können Formeln, die nicht universell sind, mit Hilfe der
Skolemisierung in universelle Formeln transformiert werden, die in
einem gewissen Sinn äquivalent zu den ursprünglichen
Formeln sind. Insgesamt wird das angestrebte Ziel damit für
alle Formeln erreicht.
Im folgenden werden wir zunächst universelle Formeln
behandeln, danach Herbrand-Interpretationen und schließlich
die Skolemisierung.
Eigenschaften von Formeln der Prädikatenlogik erster Stufe,
insbesondere im Zusammenhang mit Herbrand-Interpretationen,
hängen oft davon ab, welche Quantoren in den Formeln vorkommen
und wo sie relativ zu Negationsjunktoren stehen. Sei zum Beispiel
F die Formel ¬(∃x p(x)∨¬∀y q(y)). Es gilt:
| F |
= |
¬(∃x p(x)∨¬∀y q(y)) |
|
|
 |
(¬∃x p(x)∧¬¬∀y q(y)) |
de Morgan'sche Regel (Satz 3.3.7) |
|
|
(¬∃x p(x)∧∀y q(y)) |
Regel der doppelten Negation(3.3.7) |
|
|
(∀x ¬p(x)∧∀y q(y)) |
Regel der negierten Quantoren(3.5.13) |
In
F kommen zwar rein syntaktisch ein Existenzquantor und ein Allquantor vor, aber
,,eigentlich`` sind beide Variablen in
F allquantifiziert.
Dieses ,,eigentlich`` wird durch die sogenannte Polarität
formalisiert. Die Teilformel ∃x p(x) hat
negative Polarität in F, weil die Teilformel in F
im Bereich einer Negation steht. Die Teilformel ∀y q(y) hat
dagegen positive Polarität in F, weil sie im Bereich von zwei Negationen steht, die
einander ja aufheben. Existenzquantoren mit negativer
Polarität in einer Formel wirken wie Allquantoren mit
positiver Polarität.
Definition 3.8.1 Polarität
Für eine Formel
F sind die Polaritäten
der Vorkommen
von Teilformeln von
F wie folgt rekursiv definiert.
Statt ,,G hat positive Polarität in F`` sagt
man auch ,,G kommt positiv in F vor`` oder kürzer
,,G ist positiv in F``, und
entsprechend für negativ. Die Definition
ist der Übersichtlichkeit halber mit der kürzesten
Sprechweise formuliert.
-
F ist positiv in F.
-
Sei G ein Vorkommen
einer Teilformel von F der Gestalt G1:
Ist G positiv in F, so ist G1 negativ in F.
Ist G negativ in F, so ist G1 positiv in F.
-
Sei G ein Vorkommen einer Teilformel von F der
Gestalt (G1∧G2) oder (G1∨G2):
Ist G positiv in F, so sind G1 und G2 positiv in F.
Ist G negativ in F, so sind G1 und G2 negativ in F.
-
Sei G ein Vorkommen einer Teilformel von F der
Gestalt (G1⇒G2):
Ist G positiv in F, so ist G1
negativ in F und G2 positiv in
F.
Ist G negativ in F, so ist G1
positiv in F und G2 negativ in
F.
-
Sei G ein Vorkommen einer Teilformel von F der
Gestalt (G1⇔G2):
G1 und G2 sind sowohl positiv in F als auch negativ in F.
-
Sei G ein Vorkommen einer Teilformel von F der
Gestalt Qx G1 für einen Quantor Q:
Ist G positiv in F, so ist G1 positiv in F.
Ist G negativ in F, so ist G1 negativ in F.
In diesem Fall sprechen wir auch von der Polarität des
Vorkommens des Quantors Q
und meinen damit die Polarität des Vorkommens G der Teilformel, die mit Q beginnt.
Für Informatiker ist diese Definition am einfachsten
dadurch zu veranschaulichen, dass sie sich die Formel F durch ihren Syntaxbaum dargestellt
denken, also einen Baum, dessen Blätter die Vorkommen von
atomaren Teilformeln von F
sind und dessen innere Knoten mit Junktoren und Quantoren
beschriftet sind. Die Wurzel dieses Baums wird wegen 1. als positiv
markiert. Der Rest der Definition gibt an, wie das Vorzeichen auf
alle Nachfolgerknoten bis hin zu den Blättern propagiert
wird.
Bei dieser Propagation wechselt das Vorzeichen bei jedem
Negationsjunktor. Sei zum Beispiel F die Formel ¬¬¬p,
dann haben ¬¬¬p und ¬p
positive Polarität in F, während ¬¬p und p
negative Polarität in F haben. Die Polarität eines
Vorkommens einer Teilformel drückt aus, ob dieses Vorkommen im
Bereich einer geraden oder einer ungeraden Anzahl von Negationen
steht, ob diese Negationen einander also aufheben oder nicht.
Das Vorzeichen wechselt außerdem auf der linken Seite des
Implikationsjunktors ⇒. Nach Satz 3.5.13 und
Satz 3.3.7 gilt
(G1⇒G2) (¬G1∨G2).
Die linke Teilformel G1 steht also ,,eigentlich`` im Bereich einer impliziten Negation, die bei der Definition der Polarität mit berücksichtigt
wird.
Ist F eine Formel, in der der Äquivalenzjunktor ⇔ nicht auftritt,
so ist jedes Vorkommen einer Teilformel von F eindeutig als ein
Vorkommen positiver oder negativer Polarität klassifiziert.
Dagegen haben alle Teilformeln, die im Syntaxbaum unterhalb
eines Äquivalenzjunktors vorkommen, sowohl positive als auch
negative Polarität. Die Begründung dafür liefert die
Regel zur Auflösung des Äquivalenzjunktors nach
Satz 3.5.13 und
Satz 3.3.7:
(G1⇔G2)
((¬G1∨G2)∧(G1∨¬G2)).
Jede der beiden unmittelbaren Teilformeln von (G1⇔G2) kommt also
,,eigentlich`` einmal negiert und einmal unnegiert vor. Das gleiche
gilt mit der zweiten Regel (G1⇔G2)
((G1∧G2)∨(¬G1∧¬G2)).
Tritt eine Teilformel mehrfach in einer Formel auf, so
können verschiedene Vorkommen der Teilformel unterschiedliche
Polaritäten haben. Ist zum Beispiel F die Formel (p ∨ ¬p), hat das erste
Vorkommen von p positive Polarität in F und das
zweite negative.
Definition 3.8.2 (Pränexform)
Eine Formel
F ist in
Pränexform,
wenn sie die Gestalt
Q1x1...Qnxn G hat,
n≥0,
wobei die
Qi Quantoren sind und in
G kein Quantor vorkommt.
Satz 3.8.3.
Sei
F eine
-Formel,
in der kein Quantor in einer Teilformel vorkommt,
die mit dem Äquivalenzjunktor ⇔ gebildet ist.
Seien
Q1x1...Qnxn die Vorkommen von
Quantoren mit ihren Variablen in textueller Reihenfolge in
F, und es gelte,
dass die Variablen
xi paarweise
verschieden sind und keine der Variablen
xi frei in
F vorkommt.
Sei F' die Formel, die durch Streichen aller Vorkommen
Qixi aus F entsteht. Zu jedem der Qi
sei Q'i der gleiche Quantor wie Qi, falls
Qi positive Polarität in F hat,
und der entgegengesetzte Quantor, falls Qi negative Polarität in F hat.
Dann gilt F
Q'1x1...Q'nxn F'.
Beispiel:
Für F=¬(∃x1 p(x1)∨ ¬∀x2 q(x2))
ist F'=¬(p(x1)∨ ¬q(x2)), und es gilt
F
∀x1∀x2¬(p(x1)∨ ¬q(x2)).
Beweis:
Durch vollständige Induktion über die Anzahl
n der Vorkommen von Quantoren in
F.
Induktionsbasis n=0: Dann ist F=F' und die Behauptung gilt.
Induktionsschritt n→n+1: Die Behauptung gelte für Formeln mit n Vorkommen von
Quantoren. Seien Q1x1 Q2x2...Qn+1xn+1
die Vorkommen von Quantoren mit ihren Variablen in textueller Reihenfolge in
F. Davon ist Q1x1 also das textuell erste Vorkommen.
Für beliebige Formeln G und H, wo die
Variable x1 nicht in H vorkommt, gelten
folgende logische Äquivalenzen:
| ¬∀x1G |
|
∃x1¬G |
|
| (∀x1G∧H) |
|
∀x1(G∧H) |
| (∀x1G∨H) |
|
∀x1(G∨H) |
| (∀x1G⇒H) |
|
∃x1(G⇒H) |
|
| (H∧ ∀x1G) |
|
∀x1(H∧G) |
| (H∨ ∀x1G) |
|
∀x1(H∨G) |
| (H⇒ ∀x1G) |
|
∀x1(H⇒G) |
| ¬∃x1G |
|
∀x1¬G |
|
| (∃x1G∧H) |
|
∃x1(G∧H) |
| (∃x1G∨H) |
|
∃x1(G∨H) |
| (∃x1G⇒H) |
|
∀x1(G⇒H) |
|
| (H∧ ∃x1G) |
|
∃x1(H∧G) |
| (H∨ ∃x1G) |
|
∃x1(H∨G) |
| (H⇒ ∃x1G) |
|
∃x1(H⇒G) |
Hat eine Teilformel von F eine der Gestalten auf der linken Seite von
in
dieser Liste, ist sichergestellt, dass die Variable nicht in der
jeweiligen Teilformel H vorkommt, weil die quantifizierten Variablen von
F paarweise verschieden sind und außerdem nicht frei in F vorkommen.
Wenn das erste Quantorvorkommen Q1x1
nicht am Anfang von F steht, gibt es ein Vorkommen einer Teilformel von
F, das eine der Gestalten auf der linken Seite von
in
dieser Liste hat (nach Voraussetzung kommt Q1x1
nicht in einer mit ⇔ gebildeten Teilformel vor). Aufgrund des Ersetzungssatzes
(Satz 3.5.13 und
Satz 3.3.6)
können wir dieses Vorkommen durch die entsprechende Formel auf
der rechten Seite von
ersetzen und erhalten mit diesem Ersetzungsschritt eine zu F logisch äquivalente Formel.
Dieser Ersetzungsschritt verschiebt das erste Quantorvorkommen
Q1x1 nach links, so
dass es weiterhin das erste bleibt, wobei sich möglicherweise
der Quantor ändert. Ansonsten bleibt aber die Struktur der
Formel unverändert.
Durch Wiederholung derartiger Ersetzungsschritte erhalten wir
eine Formel Q'1x1 F1 mit
F
Q'1x1 F1,
wobei F1 durch Streichen von Q1x1 aus F entsteht.
Ein Vergleich der obigen Liste mit
Definition 3.8.1 zeigt, dass sich
beim Verschieben nach links der Quantor genau in den Fällen
ändert, in denen sich auch die Polarität des Quantors
ändert. Q'1 hat
positive Polarität in Q'1x1 F1, also
ist Q'1 der gleiche
Quantor wie Q1, falls Q1 positive
Polarität in F hat,
und der entgegengesetzte Quantor, falls Q1 negative Polarität in F hat.
Nun ist F1 eine Formel
mit n Quantorvorkommen Q2x2...Qn+1xn+1
in dieser textuellen Reihenfolge, die die gleichen
Voraussetzungen erfüllt wie F. Nach Induktionsannahme gilt
F
Q'2x2...Q'n+1xn+1 F'1
mit den geforderten Eigenschaften. Insbesondere ist F'1=F'. Mit
F
Q'1x1 F1
gilt F
Q'1x1 Q'2x2...Q'n+1xn+1 F'
mit allen geforderten Eigenschaften.
Wegen der Regel zur Auflösung des Äquivalenzjunktors
(Satz 3.5.13 und
Satz 3.3.7) ist jede
geschlossene -Formel
logisch äquivalent zu einer geschlossenen
-Formel,
in der der Äquivalenzjunktor ⇔ nicht vorkommt. Mit den Variablenumbenennungsregeln
(Satz 3.5.13) kann
außerdem stets erreicht werden, dass die quantifizierten
Variablen in einer Formel paarweise verschieden und verschieden von
den Variablen sind, die frei in der Formel vorkommen. Insgesamt
erhalten wir damit:
Folgesatz 3.8.4 (Pränexform)
Jede geschlossene
-Formel
ist logisch äquivalent zu einer geschlossenen
-Formel
in Pränexform. Enthält die Formel keinen
Quantor in einer mit ⇔ gebildeten Teilformel, so ist ihre Pränexform bis auf
Variablenumbenennung eindeutig bestimmt.
Definition 3.8.5 (Universelle Formel).
Eine geschlossene
-Formel
heißt universell,
wenn
-
keine Teilformel der Gestalt ∃x G positiv
in ihr vorkommt und
-
keine Teilformel der Gestalt ∀x G negativ
in ihr vorkommt.
Bemerkung: In der
Vorlesung ,,Theorie der Logikprogrammierung`` werden die
universellen Formeln in einer etwas anderen Weise definiert, weil
die zugrundeliegende Syntax eine andere ist.
Aus der Definition der Polarität ergibt sich unmittelbar,
dass eine Formel, die einen Quantor in einer mit ⇔ gebildeten
Teilformel enthält, nicht universell sein
kann.
Folgesatz 3.8.6
Eine geschlossene
-Formel,
die keinen Quantor in einer mit ⇔ gebildeten Teilformel enthält, ist universell genau
dann wenn ihre Pränexform keine Existenzquantoren
enthält.
Wenn Herbrand-Interpretationen, wie in der Einleitung
erläutert, auf einem ausgezeichneten Universum basieren,
stellt sich die Frage, woraus so ein ausgezeichnetes Universum
überhaupt bestehen kann. Da es stellvertretend für alle
denkbaren Universen stehen soll, müsste es
,,Universal`` enthalten in dem Sinn, dass Objekte jeglicher
anderer Universen damit repräsentiert werden können. Ob
es so ein ,,Universaluniversum`` überhaupt gibt, erscheint auf
den ersten Blick äußerst fraglich.
Bei näherer Betrachtung sind uns solche
,,Universalobjekte`` aber längst wohlvertraut. Wir benutzen
doch ständig die syntaktischen Terme einer Sprache der
Prädikatenlogik erster Stufe, um damit die Objekte beliebiger
Universen zu repräsentieren. Mit anderen Worten, die Menge
aller Terme, oder vielleicht die Menge gewisser Terme, einer
Sprache der Prädikatenlogik erster Stufe wäre doch ein
naheliegender Kandidat für das angestrebte ausgezeichnete
Universum.
Dieser Gedanke kann natürlich Verwirrung stiften. Bisher
haben wir Syntax und Semantik sorgfältig auseinandergehalten.
Wenn die Grundlage aller semantischen Begriffe, das Universum,
jetzt aus Termen bestehen soll, also aus syntaktischen Elementen,
ist eine gewisse Vermischung von Syntax und Semantik unvermeidlich.
Diese begriffliche Verwirrung ist sicherlich ein Nachteil des
Ansatzes.
Andererseits kennen wir aus der Informatik analoge Fälle
von scheinbarer begrifflicher Verwirrung, die sich als
äußerst vorteilhaft erweisen. Zum Beispiel muss man bei
einem Übersetzer Quellsprache, Zielsprache und
Implementierungssprache sorgfältig auseinanderhalten. Wenn man
dann Übersetzer betrachtet, deren Implementierungssprache
gleich ihrer Quellsprache ist, wirkt dies zunächst verwirrend
oder sogar unsinnig. Dabei stellt sich aber heraus, dass solche
Übersetzer sogar besonders nützliche Eigenschaften haben.
In ähnlicher Weise erweist sich die Vermischung von Syntax und
Semantik in der Logik als nützlich.
Zur Realisierung des Ansatzes bleibt noch zu klären, ob das
ausgezeichnete Universum aus allen Termen der Sprache bestehen soll
oder nur aus bestimmten Termen. Diese Entscheidung führt zu
technischen Unterschieden, aber keinen prinzipiellen.
Herbrand-Interpretationen benutzen als Universum die Menge aller
Grundterme, also der variablenfreien Terme.
Das Herbrand-Universum einer Sprache
der Prädikatenlogik erster Stufe ist die Menge aller
Grundterme der Sprache. Wir erinnern an eine Voraussetzung in der
Definition von
(Definition 2.3.1): ,,Es wird vorausgesetzt,
dass
mindestens eine Konstante enthält.`` Dank dieser Voraussetzung
ist die Menge der Grundterme nicht leer und kann daher als
Universum dienen. (Das war der einzige Grund für die
Voraussetzung.)
Definition 3.8.7 (Herbrand-Interpretation).
-
Sei
eine Sprache der Prädikatenlogik erster Stufe. Die Menge aller
Grundterme von
heißt Herbrand-Universum von
und wird HU
notiert. Die Menge aller Grundatome von
heißt Herbrand-Basis von
und wird HB
notiert.
-
Eine -Interpretation
M=(D,Ab,U) heißt Herbrand-Interpretation,
wenn:
-
D die Menge aller Grundterme von
ist, also D=HU, und
-
für jeden Grundterm t gilt Ab(t)=t, also:
Ab(c)=c für jedes 0-stellige Funktionssymbol c
von .
Ab(f)(t1,...,tn)=f(t1,...,tn)
für alle Grundterme t1,...,tn
für jedes n-stellige (n≥1) Funktionssymbol f
von .
-
Eine Herbrand-Interpretation, die ein Modell einer Formel oder
Formelmenge F ist,
heißt ein Herbrand-Modell von F.
Von den Bestandteilen einer Interpretation ist für
Herbrand-Interpretationen also der überwiegende Teil von
vornherein vorgegeben. Das Universum ist immer die Menge der
Grundterme. Die Funktion Ab ist für Konstanten und Funktionssymbole immer so
festgelegt, dass jeder Grundterm ,,mit sich selbst`` interpretiert
wird. Das einzige, was einer Herbrand-Interpretation überhaupt
noch an eigenen Definitionsmöglichkeiten offensteht, ist die
relativ uninteressante Umgebung sowie die Definition der Funktion Ab
für Relationssymbole.
Um letztere zu definieren, muss die Herbrand-Interpretation
festlegen, welche Relation, also welche Menge von Tupeln von
Grundtermen, jedem Relationssymbol zugeordnet ist. Wenn man vor ein
Tupel von Grundtermen das Relationssymbol schreibt, erhält man
ein Grundatom. Das, was eine Herbrand-Interpretation neben der
Umgebung überhaupt noch festlegen muss, lässt sich damit
bequem durch eine Menge B
von Grundatomen repräsentieren, also eine Teilmenge der
Herbrandbasis HB.
Definition 3.8.8
(Von einer Menge von Grundatomen repräsentierte Herbrand-Interpretation).
Sei
B⊆
HB.
Sei
U eine
HU-Umgebung.
Die von
B repräsentierte
Herbrand-Interpretation mit Umgebung
U ist die Herbrand-Interpretation
(
HU,
Ab,U) mit:
-
Ab(p)=w gdw. p∈B
für jedes 0-stellige Relationssymbol p von
.
-
Ab(p)={(t1,...,tn) | p(t1,...,tn)∈B}
für jedes n-stellige (n≥1) Relationssymbol p von
.
Sei c eine fest gewählte Konstante von
,
und sei Uc die Umgebung, die jede Variable auf c abbildet.
 bezeichnet die von B repräsentierte Herbrand-Interpretation mit
Umgebung Uc.
Satz 3.8.9.
Sei
M=(HU,Ab,U)
eine Herbrand-Interpretation einer Sprache
der PL1S, sei
t ein
-Term,
F eine
-Formel,
x eine Variable.
-
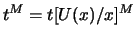 .
-
ist
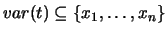 , dann ist
tM=t[U(x1)/x1]...[U(xn)/xn].
-
MF
gdw.MF[U(x)/x].
Beweis:
Es gilt stets M=M[U(x)/x], und wenn M eine
Herbrand-Interpretation und somit U(x) ein Grundterm ist,
gilt U(x)M=U(x), also M=M[U(x)M/x]. Damit
sind 1. und 3. einfach Spezialfälle des
Substitutionssatzes
3.5.12.
2. folgt aus 1. und weil t[U(x1)/x1]...[U(xn)/xn]
ein Grundterm und somit gleich t[U(x1)/x1]...[U(xn)/xn]M ist.
Für beliebige Interpretationen übersetzt der
Substitutionssatz zwischen einer Umgebung, die einer Variablen
semantisch ein Objekt des Universums zuordnet, und einer
Substitution, die eine Variable syntaktisch durch einen Term
ersetzt. Der obige Satz zeigt, dass für
Herbrand-Interpretationen, wo die Objekte des Universums Terme
sind, Umgebungen und Substitutionen zusammenfallen. Die Vermischung
von Syntax und Semantik bei Herbrand-Interpretationen ist hier also
günstig, weil sie eine Vereinfachung bewirkt.
Satz 3.8.10
Sei
M eine
Herbrand-Interpretation einer Sprache
der PL1S, sei
F eine
-Formel
(in der
x frei vorkommen kann, aber nicht muss).
-
M∀x F
gdw. für jeden Grundterm t gilt
MF[t/x].
-
M∃x F
gdw. es gibt einen Grundterm t gilt
MF[t/x].
Beweis:
Satz 3.8.9 (3) anwenden.
Der Satz 3.8.10 gilt für
Nicht-Herbrand-Interpretationen im allgemeinen nicht. Wir betrachten zwei Gegenbeispiele.
Beispiel 3.8.11.
Die Sprache
bestehe aus einer Konstanten
a und einem einstelligen Relationssymbol
p und sonst keinen Symbolen.
Sei
M=({1,2},Ab,U) mit
Ab(a)=1 und
Ab(p)={1}.
Es gilt
Mp(a) und
M[1/x]p(x) und
M[2/x]nichtp(x).
Der einzige Grundterm ist
a.
1. Für jeden Grundterm
t gilt
Mp(x)[t/x],
aber
Mnicht∀x p(x).
2.
M∃x ¬p(x), aber es
gibt keinen Grundterm
t mit
M¬p(x)[t/x].
Hier ist der Satz deshalb verletzt, weil es nur einen einzigen
Grundterm gibt, aber zwei Objekte im Universum, so dass das Objekt
2 des Universums durch
gar keinen Grundterm repräsentiert ist. Man könnte
vermuten, dass dieses Phänomen leicht zu vermeiden sei, sobald
die Sprache Funktionssymbole enthält, denn dann gibt es ja
unendlich viele Grundterme. Das nächste Beispiel zeigt aber,
dass das Phänomen prinzipiell nicht vermeidbar ist.
Beispiel 3.8.12.
Die Sprache
bestehe aus abzählbar unendlich vielen Konstanten und zu jeder
Stelligkeit abzählbar unendlich vielen Funktionssymbolen sowie
aus einem einstelligen Relationssymbol
p.
ℜ bezeichne
die Menge der reellen Zahlen. Sei
M=(ℜ,Ab,U) mit
Ab(p)={tM | t Grundterm. Da es nur abzählbar viele Grundterme gibt, gibt es
d∈ℜ mit
d∉
Ab(p), so dass
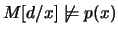
.
1. Für jeden Grundterm
t gilt
Mp(x)[t/x],
aber
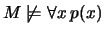
.
2.
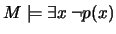
, aber es
gibt keinen Grundterm
t mit
M¬p(x)[t/x].
Man kann zu jeder beliebigen Interpretation M auf natürliche Weise eine
Herbrand-Interpretation konstruieren, die M weitgehend nachbildet.
Satz 3.8.13.
Sei
eine Sprache der PL1S, sei
M eine
-Interpretation,
sei
BM:={
A∈HB |
MA}. Die von
BM
repräsentierte Herbrand-Interpretation

hat folgende Eigenschaften:
- Für jede quantorfreie geschlossene Formel F gilt:
MF gdw.
F
- Für jede universelle geschlossene Formel F gilt:
wenn MF, dann
F
Beweis:
-
Durch strukturelle Induktion.
Basisfall  oder
 :
ergibt sich unmittelbar aus der Definition von
.
Basisfall Atom: da F quantorfrei und geschlossen ist, ist
F ein Grundatom, also gilt
MF
gdw. F∈BM gdw.
F.
Induktionsfall Junktor: ergibt sich
unmittelbar durch Anwendung der Definition von
auf die Induktionsannahme.
Induktionsfall Quantor: tritt nicht auf, da F quantorfrei ist.
-
Es gelte MF.
Da F universell ist, enthält seine nach
Satz 3.8.3 gebildete
Pränexform
 keine Existenzquantoren. Wegen
 gilt
 .
Wir zeigen durch vollständige Induktion über die
Anzahl n der Quantoren
in :
wenn , dann
Mit erhalten wir
dann
F, was zu zeigen war.
Induktionsbasis n=0: Es gelte .
Enthält
keinen Quantor, ist es eine quantorfreie geschlossene Formel, und nach 1. gilt
.
Induktionsschritt n→n+1: Enthält
n+1 Quantoren, hat es die Gestalt
 .
Es gelte ,
also
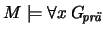 .
Nach Definition bedeutet dies, wenn D das Universum
von M bezeichnet, dass für jedes d∈D gilt
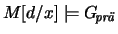 .
Angenommen, es gäbe einen Grundterm t mit
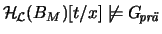 , das heißt nach
Satz 3.8.9,
[t/x]. Nach dem Koinzidenzsatz 3.5.10 folgt daraus,
da
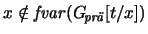 ist,

 . Da die Formel
eine
geschlossene universelle Formel in Pränexform mit n Quantoren ist, können wir mit
der Induktionsannahme weiter folgern dass
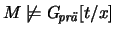 .
Nach dem Substitutionssatz 3.5.12 müsste dann
gelten
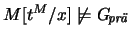 ,
im Widerspruch dazu dass für jedes d∈D gilt
.
Also gibt es keinen Grundterm t mit
,
das heißt, für jeden Grundterm t gilt
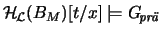 .
Das ist aber gerade die Definition von
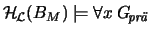 ,
also
.
Es mag verwundern, dass der zweite Teil dieses Satzes nur mit
,,wenn dann`` formuliert ist und nicht mit ,,genau dann wenn``.
Tatsächlich gilt die Gegenrichtung im allgemeinen nicht. Der
Grund sind genau die obigen
Beispiele 3.8.11 und
3.8.12.
Für die darin angegebene Interpretation M gilt jeweils
∀x p(x),
aber .
Die Beispiele zeigen außerdem die Notwendigkeit der
Voraussetzung, dass F universell ist. In den Beispielen gilt jeweils
M∃x ¬p(x),
aber
nicht∃x ¬p(x).
Der Zusammenhang zwischen der Erfüllung einer Formel durch
eine beliebige Interpretation und der Erfüllung der Formel
durch die aus der Interpretation konstruierte
Herbrand-Interpretation ist also nicht sehr stark. Trotzdem hat er
weitreichende Konsequenzen.
Folgesatz 3.8.14.
Sei
F∀ eine
geschlossene universelle Formel. Sei
S∀ eine Menge von solchen Formeln. Sei
G∃ eine geschlossene
Formel derart dass ¬
G∃ universell ist.
- G∃ ist
allgemeingültig gdw. jede Herbrand-Interpretation erfüllt
G∃.
- G∃ ist
falsifizierbar gdw. eine Herbrand-Interpretation falsifiziert
G∃.
- F∀ ist
erfüllbar gdw. eine Herbrand-Interpretation erfüllt
F∀.
- F∀ ist
unerfüllbar gdw. jede Herbrand-Interpretation falsifiziert
F∀.
- S∀ ist
erfüllbar gdw. S∀ ein Herbrand-Modell besitzt.
- F∀
G∃
gdw. jedes Herbrand-Modell von F∀ auch G∃
erfüllt.
- S∀
G∃
gdw. jedes Herbrand-Modell von S∀ auch G∃
erfüllt.
Für die Formeln und Formelmengen mit den angegebenen
syntaktischen Eigenschaften ist damit das eingangs motivierte Ziel
erreicht. Zum Nachweis der Folgerungsbeziehung reicht es wegen der
letzten beiden Ergebnisse aus, die Überprüfung auf
Herbrand-Interpretationen und damit auf ein einziges Universum zu
beschränken.
Übrigens hätte die Motivation in der Einleitung zu
Abschnitt 3.8
nicht unbedingt auf der Folgerungsbeziehung aufgebaut
werden müssen. Eine analoge Motivation wäre auch mit der
Erfüllbarkeit oder einem anderen der semantischen Begriffe
möglich gewesen. Die ersten Ergebnisse des Satzes zeigen, dass
das Ziel auch für diese anderen semantischen Begriffe jetzt
erreicht ist: zum Nachweis der jeweiligen semantischen Eigenschaft
müssen nicht mehr sämtliche Interpretationen betrachtet
werden, sondern nur noch die Herbrand-Interpretationen, jedenfalls
für Formeln und Formelmengen mit den angegebenen syntaktischen
Eigenschaften.
Definition 3.8.15 (Grundinstanzen).
Sei
F=∀x1 ... ∀xn G eine geschlossene
universelle Formel in Pränexform. Die Menge der
Grundinstanzen von
F ist die
Formelmenge {
G[t1/x1]...[tn/xn] |
ti Grundterm}.
Sei S eine Menge von
geschlossenen universellen Formeln in Pränexform. Die Menge
der Grundinstanzen von S ist
die Vereinigung der Mengen von Grundinstanzen der Formeln in S.
Aus Satz 3.8.10 folgt unter Zuhilfenahme von
Satz 3.8.14 unmittelbar ein
weiteres Ergebnis mit sehr weitreichenden Konsequenzen, auf die
Kapitel 4 näher eingehen wird.
Folgesatz 3.8.16.
Sei
S eine Menge von geschlossenen
universellen Formeln in Pränexform.
S ist erfüllbar gdw. die Menge der
Grundinstanzen
von
S ein Herbrand-Modell besitzt.
In diesem Abschnitt zeigen wir, dass zu jeder endlichen Menge S
von (beliebigen)
geschlossenen Formeln eine Menge S* von universellen geschlossenen
Formeln konstruiert werden kann, so dass S* genau dann ein Modell hat,
wenn S ein Modell hat. Dieses Ergebnis reicht
aus, um die Folgerungsbeziehung für beliebige Formeln durch
die Überprüfung von Herbrand-Interpretationen nachweisen
zu können. Das Verfahren, mit dem S* aus S
konstruiert wird, nennt man Skolemisierung.
Der genaue Zusammenhang zwischen S und S ist
allerdings etwas komplizierter. Die Menge S
enthält -Formeln
für eine gegebene Sprache
der Prädikatenlogik erster Stufe. Diese Sprache wird
zunächst um zusätzliche Funktionssymbole erweitert zu
einer Sprache *. Die Menge S
besteht dann aus *-Formeln.
Man muss deshalb auch zwischen -Interpretationen und
*-Interpretationen unterscheiden. Das ist der wesentliche
Grund, dass S und
S nicht einfach logisch
äquivalent sind. Aber die Beziehung zwischen den Modellen von
S (bezüglich
)
und den Modellen von S
(bezüglich *) wird sich
als sehr viel enger erweisen, als es für
das obengenannte Gesamtergebnis erforderlich ist.
Um die Grundidee der Skolemisierung informell zu verstehen,
betrachten wir noch einmal die Axiome einer Boole'schen Algebra
nach Definition 3.2.1.
Das erste Axiom verlangt unter anderem, dass es ein neutrales
Element für die Operation  gibt.
Die unmittelbare Übersetzung dieser
Forderung ergäbe folgende Formel der Prädikatenlogik
erster Stufe: ∃y∀x
(yx
 x).
Tatsächlich wurde das Axiom aber so formuliert, dass die
entsprechende Formel der Prädikatenlogik erster Stufe lautet:
∀x(1x
x). Das als existent
geforderte Element wurde also durch eine Konstante
repräsentiert statt durch eine existentiell quantifizierte
Variable.
Das letzte Axiom verlangt unter anderem, dass es zu jedem
Element ein komplementäres Element bezüglich der
Operation + gibt. Diese
Forderung lässt sich darstellen durch die Formel
∀x∃y
(x+y1), aber auch durch
die Formel ∀x
(x+‾x1). Dabei ist
‾ ein Funktionssymbol, das für eine Funktion stehen soll, die zu jedem x ein
komplementäres Element liefert.
Ein als existent gefordertes Objekt kann also statt durch eine
existentiell quantifizierte Variable auch durch einen Term
repräsentiert werden, der mit einem Funktionssymbol gebildet
ist. Die Unterterme in diesem Term repräsentieren Objekte, von
denen das als existent geforderte abhängt. Im ersten Beispiel
bestand so eine Abhängigkeit nicht, so dass der Term mit einem
nullstelligen Funktionssymbol, also einer Konstanten, gebildet
wurde.
Die Skolemisierung benutzt dieses Prinzip, um systematisch alle
Existenzquantoren positiver Polarität und Allquantoren
negativer Polarität zu beseitigen und dadurch zu universellen
Formeln zu gelangen.
Um die entsprechenden Ergebnisse beweisen zu können,
benötigen wir als Hilfsmittel einige Varianten des
Ersetzungssatzes.
Satz 3.8.17 (Ersetzungssatz für Folgerungen).
F,
G1,
G2 seien
-Formeln und
VG1
sei ein Vorkommen von
G1
als Teilformel in
F mit
eindeutiger Polarität. Es bezeichne
F⟨
G2,
VG1⟩ die
-Formel, die aus
F
entsteht, wenn das Vorkommen
VG1 von
G1
in
F durch
G2 ersetzt wird. Dann gilt:
| |
1. |
|
Wenn VG1 positiv in F |
|
und G1G2, |
|
dann FF⟨G2,
VG1⟩. |
| |
2. |
|
Wenn VG1 positiv in F |
|
und G2G1, |
|
dann F⟨G2,
VG1⟩F. |
| |
3. |
|
Wenn VG1 negativ in F |
|
und G1G2, |
|
dann F⟨G2,
VG1⟩F. |
| |
4. |
|
Wenn VG1 negativ in F |
|
und G2G1, |
|
dann FF⟨G2,
VG1⟩. |
Beweis: Strukturelle Induktion.
Bei Ersetzung eines Vorkommens einer Teilformel
überträgt sich also die Folgerungsbeziehung von der
Teilformel auf die Gesamtformel, sofern das Vorkommen positive
Polarität hat. Hat das Vorkommen negative Polarität,
überträgt sich die Folgerungsbeziehung in
entgegengesetzter Richtung auf die Gesamtformel. Hat ein Vorkommen
sowohl positive als auch negative Polarität,
überträgt sich die Folgerungsbeziehung im allgemeinen
weder in die eine noch in die andere Richtung. Sei zum Beispiel
G1=(p∧q) und G2=(p∨q),
dann gilt G1G2. Sei
F=((p∧q)⇔¬q), dann ist
F⟨G2, VG1⟩=((p∨q)⇔¬q).
Man rechnet leicht nach, dass sowohl F als auch F⟨G2, VG1⟩
ein Modell haben, dass aber keine Interpretation beide
Formeln erfüllt, so dass die Folgerungsbeziehung in keiner
Richtung besteht.
Der Ersetzungssatz 3.3.6 und
3.5.13 ist ein Spezialfall dieses
allgemeineren Ersetzungssatzes für Folgerungen.
Wofür ist diese Verallgemeinerung erforderlich? Insgesamt
wird es darum gehen, dass eine ,,große`` Formel F gegeben ist. Darin kommt eine
,,kleine`` Teilformel vor, die mit einem störenden Quantor
beginnt. Wenn man diese Teilformel durch eine andere ,,kleine``
Formel ersetzt, in der der störende Quantor beseitigt ist,
entsteht die ,,große`` Formel F'.
F = (... QxG ...)
∇
F' = (... G' ...)
Ein späterer Satz (Satz 3.8.20)
wird belegen, dass zwischen den Formeln QxG und G'
Folgerungsbeziehungen bestehen, die von den Polaritäten
abhängen. Der Ersetzungssatz für Folgerungen dient dazu,
diese Folgerungsbeziehungen von den Teilformeln auf die
,,großen`` Formeln zu übertragen wie folgt.
Wenn die Teilformel QxG positiv in F ist, hat sie die Gestalt ∃xG.
| Satz 3.8.17 (2)
sagt, dass daraus folgt: |
+
F = (... ∃xG ...)
?
F' = (... G' ...) |
Wenn die Teilformel QxG negativ in F ist, hat sie die Gestalt ∀xG.
| Satz 3.8.17 (3)
sagt, dass daraus folgt: |
-
F = (... ∀xG ...)
?
F' = (... G' ...) |
In beiden Fällen gilt also F'F.
Wird ein Existenzquantor positiver
Polarität oder ein Allquantor negativer Polarität durch
Skolemisierung beseitigt, so folgt in jedem Fall die
ursprüngliche Formel F aus der neuen Formel F' - wenn
Satz 3.8.20
bewiesen ist. (Es ist übrigens Absicht, dass gemeinsam
benutzte Unterfälle der beiden Sätze jeweils die gleiche
Nummer (2) bzw. (3) haben. Das gilt auch für die weiteren
Sätze mit Unterfällen.)
Die Gegenrichtung FF' gilt nicht.
Wir streben eine abgeschwächte Gegenrichtung an: dass man zu jedem M mit
MF ein M'
konstruieren kann mit M'F und
M'F'.
Als Vorbereitung für diese abgeschwächte Gegenrichtung
zunächst eine Betrachtung zur Folgerungsbeziehung. Für
zwei Formeln G1 und G2 gilt
G1G2 gdw.
für jedes M gilt M
(G1 ⇒ G2). Das ergibt
sich direkt aus den Definitionen. Wenn
M(G1 ⇒ G2)
nicht für jedes M gilt, sondern nur für gewisse M, kann man von einer Art schwacher Folgerungsbeziehung
sprechen.
Bei der obigen Ersetzung gilt in der Gegenrichtung nicht die
Folgerungsbeziehung zwischen QxG
und G'. Man kann
aber zu jedem Modell M von
F ein anderes Modell
M' von F so konstruieren, dass diese schwache
Folgerungsbeziehung zwischen QxG und G' besteht.
Betrachten wir zunächst nur den Fall, dass die Teilformel
positiv in F ist.
|
|
M' |
|
M' |
|
| M |
|
F |
= (... |
∃xG+ |
...) |
|
|
F' |
= (... |
G' |
...) |
Das nächste Ziel ist jetzt, diese schwache
Folgerungsbeziehung von den Teilformeln auf die ,,großen``
Formeln zu übertragen. Wenn man aus der obigen Situation
schließen kann, dass auch M'(F⇒F') gilt, dann
gilt auch M'F'.
Insgesamt hätte man damit die angestrebte Aussage, dass zu
jedem Modell M von F ein Modell M' von F'
konstruiert werden kann, das auch ein Modell von
F' ist.
Leider lässt sich diese schwache Folgerungsbeziehung nicht
für völlig beliebige M' von den Teilformeln auf die ,,großen`` Formeln
übertragen. Wenn die Beziehung
M'(∃xG⇒G')
davon abhängt, welche Umgebung die Interpretation benutzt,
dann gilt nicht immer auch
M'(F⇒F').
Die Übertragung klappt aber für Interpretationen, die
völlig unabhängig von den Umgebungen sind. Dafür
brauchen wir eine Schreibweise.
Notation 3.8.18.
Für jede
-Interpretation
M=(D,Ab,U) und jede
D-Umgebung
U bezeichne
M[U] die
-Interpretation (
D,Ab,U).
Die nächste, noch allgemeinere, Variante des
Ersetzungssatzes erlaubt die angestrebte Übertragung auf die
,,große`` Formel, wenn M' so ist, dass für jede Umgebung U
gilt M'[U](∃xG⇒G').
Dann gilt auch für jedes U, dass
M'[U] (F⇒F').
Beweis: Strukturelle Induktion.
Auch für die schwache Folgerungsbeziehung dreht sich also
die Richtung um, wenn sie von einer Teilformel negativer
Polarität auf die ,,große`` Formel übertragen
wird.
Hier noch ein Gegenbeispiel zum interpretationsspezifischen
Ersetzungssatz, wenn die Modellbeziehung von der Umgebung
abhängt:
Sei G = p(x,x) und G' = p(x,y)
Sei F = ∀x ∀y p(x,x) und F' = F[G'/G] = ∀x ∀y p(x,y).
Es gibt eine Interpretation M = (D,Ab,U) mit
M (G ⇒ G'),
nämlich D=N und Ab(p)=≤N und U(x)=U(y)=5. Die schwache
Folgerungsbeziehung zwischen G und i>G' besteht also nur deswegen, weil x und y in der
Umgebung U denselben Wert haben. Aber für dieses M gilt
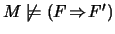 , da
M∀x ∀y p(x,y)
aber
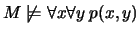 . Die
schwache Folgerungsbeziehung überträgt sich also nicht
auf die ,,großen`` Formeln.
Die Interpretationen, die mit Satz 3.8.20
konstruiert werden, hängen nicht von der Umgebung ab, deshalb
kann Satz 3.8.19 darauf angewandt werden.
Das Gesamtbild für die noch offene Gegenrichtung ist wie folgt.
| Satz 3.8.20 (1)
garantiert: |
| für jede Umgebung U gilt |
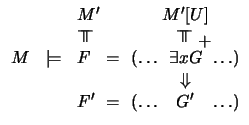 |
| Satz 3.8.19 (1)
sagt, dass daraus folgt: |
| für jede Umgebung U gilt |
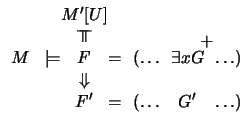 |
| Satz 3.8.20 (4)
garantiert: |
| für jede Umgebung U gilt |
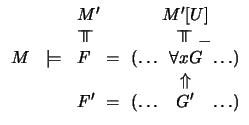 |
| Satz 3.8.19 (4)
sagt, dass daraus folgt: |
| für jede Umgebung U gilt |
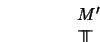 [U]
MF = (... ∀XG‾ ...)
⇓
F' = (... G' ...) |
In beiden Fällen bedeutet die Übertragung, dass für jede Umgebung U gilt. Also
gilt auch . Wie oben erläutert, ist damit aus dem Modell M von F
ein Modell M' von F und auch von F' konstruiert.
Nun aber zu dem angekündigten Satz, von dem alle obigen Schemata abhängen.
Satz 3.8.20 (Elementarer Skolemisierungsschritt).
Sei
G eine
-Formel
mit
fvar(G) = {x,y1,...,yn}. Sei
f ein
n-stelliges Funktionssymbol, das nicht in
G vorkommt. Sei
G' = G[f(y1,...,yn)/x]. Dann gilt:
-
Zu jeder -Interpretation
M = (D,Ab,U0) gibt es eine
-Interpretation M' = (D,Ab',U0),
die sich höchstens darin von M
unterscheidet, dass Ab'(f)≠Ab(f) sein kann, so dass für jede D-Umgebung
U gilt: M'[U] (∃xG⇒G').
-
G' ∃xG.
-
∀x G G'
-
Zu jeder -Interpretation
M = (D,Ab,U0) gibt es eine
-Interpretation
M' = (D,Ab',U0), die sich
höchstens darin von M
unterscheidet, dass Ab'(f)≠Ab(f) sein kann, so dass für jede
D-Umgebung U gilt:
M'[U](G'⇒∀xG).
Beweis:
-
Wir konstruieren Ab'(f) wie folgt: Sei
d0 ∈ D fest gewählt. Zu jedem n-Tupel
(d1,...,dn) ∈ Dn prüfen wir,
ob M[d1/y1]...[dn/yn]
∃xG. Gilt das
nicht, definieren wir Ab'(f)(d1,...,dn):=d0
für dieses Tupel. Gilt es, gibt es d ∈ D mit
M[d1/y1]...[dn/yn][d/x]
G, wir
wählen ein solches d und definieren Ab'(f)(d1,...,dn):=d
für dieses Tupel.
Sei U eine beliebige D-Umgebung.
Falls  , gilt
M'[U] (∃xG⇒G')
nach Definition von .
Falls M'[U] ∃xG,
ist f(y1,...,yn nach
Konstruktion ein Term mit M'[U][f(y1,...,yn)M'/x]
G, und nach dem
Substitutionssatz 3.5.12 gilt
M'[U] G[f(y1,...,yn/x],
also M'[U] G'. Nach
Definition von gilt dann auch
M'[U] (∃xG⇒G').
-
Sei M = (D,Ab,U) eine -Interpretation mit
M G', das heißt,
M G[f(y1,...,yn)/x]. Nach dem
Substitutionssatz 3.5.12 gilt, dass
M[f(y1,...,ynM/x] G.
Also gibt es d ∈ D, nämlich
d = f(y1,...,ynM, mit
M[d/x] G. Nach
Definition gilt M ∃xG.
-
Sei M = (D,Ab,U) eine -Interpretation mit
M ∀xG.
Nach Definition gilt für jedes d ∈ D dass
M[d/x] G. Also
gilt insbesondere für d = f(y1,...,ynM
dass M[f(y1,...,ynM/x]
G. Nach dem
Substitutionssatz 3.5.12 gilt, dass
M G[f(y1,...,yn)/x],
das heißt,
M G'.
-
Wir konstruieren Ab'(f) wie folgt: Sei d0 ∈ D
fest gewählt. Zu jedem n-Tupel (d1,...,dn) ∈ D
prüfen wir, ob M[d1/y1]...[dn/yn]
∀xG. Gilt
das, definieren wir Ab'(f)(d1,...,dn) := d0
für dieses Tupel. Gilt es nicht, gibt es d ∈ D mit
M[d1/y1]...[dn/yn]
nicht G, wir
wählen ein solches d und definieren Ab'(f)(d1,...,dn) := d
für dieses Tupel.
Sei U eine beliebige D-Umgebung.
Falls M'[U] ∀xG, gilt
M'[U](G'⇒∀xG).
nach Definition von .
Falls  , ist
f(y1,...,yn) nach Konstruktion ein Term mit M'[U][f(y1,...,yn)M'/x]
nicht G, und nach
dem Substitutionssatz 3.5.12 gilt
 y1,...,yn)/x], also
M'[U]nichtG'.
Nach Definition von
gilt dann auch M'[U](G'⇒∀xG).
Die Formeln ∃xG und G' (bzw. G' und ∀xG) sind also nicht logisch
äquivalent, aber fast. In der einen Richtung gilt die
Folgerungsbeziehung immer. In der anderen gilt sie nicht immer,
weil manche Interpretationen das Funktionssymbol f mit einer ,,unpassenden`` Funktion
interpretieren können. Da nach Voraussetzung f nicht in G
vorkommt, kann man in diesen Fällen aber
immer eine ,,passende`` Definition für f angeben, ohne irgend etwas anderes an der
Interpretation zu ändern, so dass die Folgerungsbeziehung
bezüglich dieser ,,angepassten`` Interpretationen auch in der
Gegenrichtung gilt.
Satz 3.8.21 (Skolemisierung).
Sei
eine Sprache der Prädikatenlogik erster Stufe und sei
F eine geschlossene
-Formel, in der jedes
Quantorvorkommen eine eindeutige Polarität hat. Dann gibt es eine Erweiterung
*
der Sprache
um
endlich viele zusätzliche Funktionssymbole und eine
universelle geschlossene
*-Formel
F*,
so dass gilt:
-
F*F
-
Zu jeder -Interpretation M
mit MF gibt es
eine *-Interpretation M*,
deren Restriktion auf die Symbole von
gleich M ist, so dass
M*F und
M*F*.
Beweis:
Durch vollständige Induktion über die Anzahl k der Vorkommen von Quantoren
falscher Polarität, also von Existenzquantoren positiver
Polarität in F und von
Allquantoren negativer Polarität in F.
Induktionsbasis k=0: Dann ist F universell, und die Behauptung gilt für
*=
und F*=F.
Induktionsschritt k→k+1: Die Behauptung gelte für
Formeln mit k Vorkommen
von Quantoren falscher Polarität. Sei F eine
-Formel mit k+1
solchen Vorkommen und sei VQx G eines davon.
Falls x∉fvar(G), sei F'=F⟨G/VQx G⟩. Nach den Regeln der
überflüssigen Quantoren (Satz 3.5.13) gilt
QxG,
also FF'.
Die Formel F' enthält k Vorkommen
von Quantoren falscher Polarität. Die Behauptung ergibt sich
direkt aus der Induktionsannahme.
Andernfalls sei fvar(G)={x,y1,...,yn}. Sei
f ein n-stelliges Funktionssymbol, das nicht zu der
Sprache
gehört, und sei '
die Erweiterung von um
f. Sei G'=G[f(y1,...,yn)/x] und
F'=F⟨G/VQx G⟩. Dann ist F' eine
geschlossene '-Formel.
Mit den vorigen Sätzen gilt F'F,
im positiven Fall nach Satz 3.8.20 (2) und
Satz 3.8.17 (2),
im negativen Fall nach Satz 3.8.20 (3) und
Satz 3.8.17 (3).
Zu jeder -Interpretation M
mit  gibt es, im
positiven Fall nach Satz 3.8.20 (1) und
Satz 3.8.19 (1), im negativen Fall nach
Satz 3.8.20 (4) und
Satz 3.8.19 (4),
eine '-Interpretation
M', deren Restriktion auf die Symbole von
gleich M ist, so dass für jede D-Umgebung U
gilt M'[U](F⇒F'). Da
F und damit auch F' geschlossen ist, gilt nach dem
Koinzidenzsatz 3.5.10 auch
M'(F⇒F').
Wegen MF
gilt auch M'F
und nach Definition von
auch M'F'.
F' ist eine geschlossene '-Formel
mit kQuantorvorkommen falscher Polarität. Der Rest ergibt sich
unmittelbar aus der Induktionsannahme.
Bei der Skolemisierung einer Formel nach der Konstruktion in
diesem Beweis werden falsch quantifizierte Variablen der Reihe nach
durch Terme ersetzt, die mit neu eingeführten
Funktionssymbolen, sogenannten Skolem-Funktionssymbolen, gebildet
werden. Eine aus F durch
Skolemisierung gewonnene universelle Formel nennt man eine
Skolemform von F. Die
mit den Skolem-Funktionssymbolen gebildeten Terme kann man als eine
Umbenennung der Objekte auffassen, deren Existenz in der Formel
gefordert wird.
Die Skolemform ist nicht eindeutig, da sie von der Reihenfolge
abhängt, in der die Quantoren falscher Polarität ersetzt
werden. Zum Beispiel sei F
die geschlossene Formel ∀u ∃v ∃w p(u,v,w). Ersetzen wir
zuerst ∃v und dann ∃w, entsteht
zuerst ∀u ∃w p(u,f(u),w) und dann ∀u p(u,f(u),g(u)).
Letzteres ist eine Skolemform von F. In der anderen Reihenfolge entsteht erst
∀u ∃v p(u,v,h(u,v)), dann ∀u p(u,k(u),h(u,k(u))). Letzteres ist auch
eine Skolemform von F.
Es gibt verschiedene Verfahren, um eine Skolemform aus einer
Formel zu gewinnen. Neben der Festlegung der Reihenfolge der
Ersetzungen kann man auch festlegen, dass vor den Ersetzungen
zunächst die Quantoren in der Formel verschoben werden. Am
einfachsten zu verstehen ist die Skolemisierung, wenn man die
Formel zunächst in eine Pränexform umwandelt. Um die
Komplexität der neuen Terme gering zu halten, ist es dagegen
günstiger, die Quantoren zunächst möglichst weit
nach innen zu ziehen und eine sogenannte Antipränexform oder
Miniscope-Form herzustellen.
Die Voraussetzung des obigen Satzes, dass jedes Quantorvorkommen
eine eindeutige Polarität hat, lässt sich mit der Regel
zur Auflösung des Äquivalenzjunktors
(Satz 3.5.13 und
Satz 3.3.7) immer
herstellen. Also gilt:
Kombiniert mit Satz 3.8.14
ergibt sich daraus die Lösung für das
Gesamtziel dieses Abschnitts: alle semantischen Begriffe auf
Herbrand-Interpretationen zurückzuführen.
Folgesatz 3.8.23.
Seien
F und
G geschlossene Formeln und
S eine endliche Menge von geschlossenen
Formeln.
-
F ist allgemeingültig gdw. jede Herbrand-Interpretation erfüllt
¬sko(¬F).
-
F ist falsifizierbar
gdw. eine Herbrand-Interpretation falsifiziert ¬sko(¬F).
-
F ist erfüllbar
gdw. eine Herbrand-Interpretation erfüllt sko(F).
-
F ist unerfüllbar
gdw. jede Herbrand-Interpretation falsifiziert sko(F).
-
S ist erfüllbar gdw. sko(S) ein Herbrand-Modell besitzt.
-
FG gdw. jede
Herbrand-Interpretation falsifiziert sko(F∧¬G).
-
SG gdw. jede
Herbrand-Interpretation falsifiziert sko(F∪{¬G}).
Dabei beziehen sich die genannten Herbrand-Interpretationen jeweils
auf das Herbrand-Universum einer Erweiterung der
ursprünglichen Sprache um endlich viele Funktionssymbole.
Aus Satz 3.8.21 folgt ein klassisches Ergebnis.
Satz 3.8.24 (Satz von Löwenheim und Skolem).
Jede erfüllbare, geschlossene Formel einer Sprache
der PL1S ist erfüllbar durch eine
-Interpretation,
deren Universum höchstens abzählbar ist.
Folgesatz 2.8.25.
Jede erfüllbare, endliche Menge von geschlossenen Formeln einer
Sprache der PL1S ist erfüllbar durch eine Interpretation mit
höchstens abzählbarem Universum.
Bemerkungen:
Es gibt weitere Sätze, die den obigen ähneln. In
Abschnitt
3.6
wurde bereits der ,,aufsteigende Satz von Löwenheim und
Skolem`` erwähnt:
Jede Menge von geschlossenen Formeln einer Sprache
erster Stufe mit Gleichheit, die ein Modell mit unendlichem
Universum besitzt, besitzt auch ein Modell, dessen Universum
mindestens so groß wie jede beliebige Menge ist.
Satz 3.8.25
wird durch den ,,absteigenden Satz von Löwenheim
und Skolem`` verallgemeinert:
Jede erfüllbare Menge von geschlossenen Formeln
einer Sprache  mit Gleichheit besitzt ein Modell, dessen Universum nicht größer als die Menge
der -Formeln
ist.
Aus diesem Satz folgt, dass die Überabzählbarkeit in
der PL1S nicht ausdrückbar ist. Dies hat schwerwiegende Folgen
in der Mathematik, in der überabzählbare Mengen wie z.B.
ℜ eine zentrale Rolle spielen. Für die praktische
Informatik ist diese Einschränkung aber nicht so bedeutsam,
weil die Informatik vorwiegend höchstens abzählbare
Mengen untersucht.
Validierung


 von